kkato@dev:~$cat posts/btree-index.md
B-tree / B+tree インデックスを理解する
最近 Build Your Own Database From Scratch in Go という本を読んでいるのですが、B-tree まわりの説明がいまいち理解できなかったので、他の文献も参考にしつつ自分なりにまとめてみました。
リレーショナルデータベースで広く使われている B-tree と、その派生である B+tree について調べてみました。
B-tree
B-tree は各ノードが複数のキーと子へのポインタを持つ balanced tree です。ノードあたりのキーを増やせるので木の高さが低くなり、ディスクからの読み込み回数を抑えられます。
内部ノードの中身は「ポインタ → キー → ポインタ → キー → ポインタ」のように、キーの間に子ノードへのポインタが挟まる形になっています。キーが n 個あればポインタは n+1 個です。リーフノードは子を持たないので、キー(と対応する値)だけが並びます。
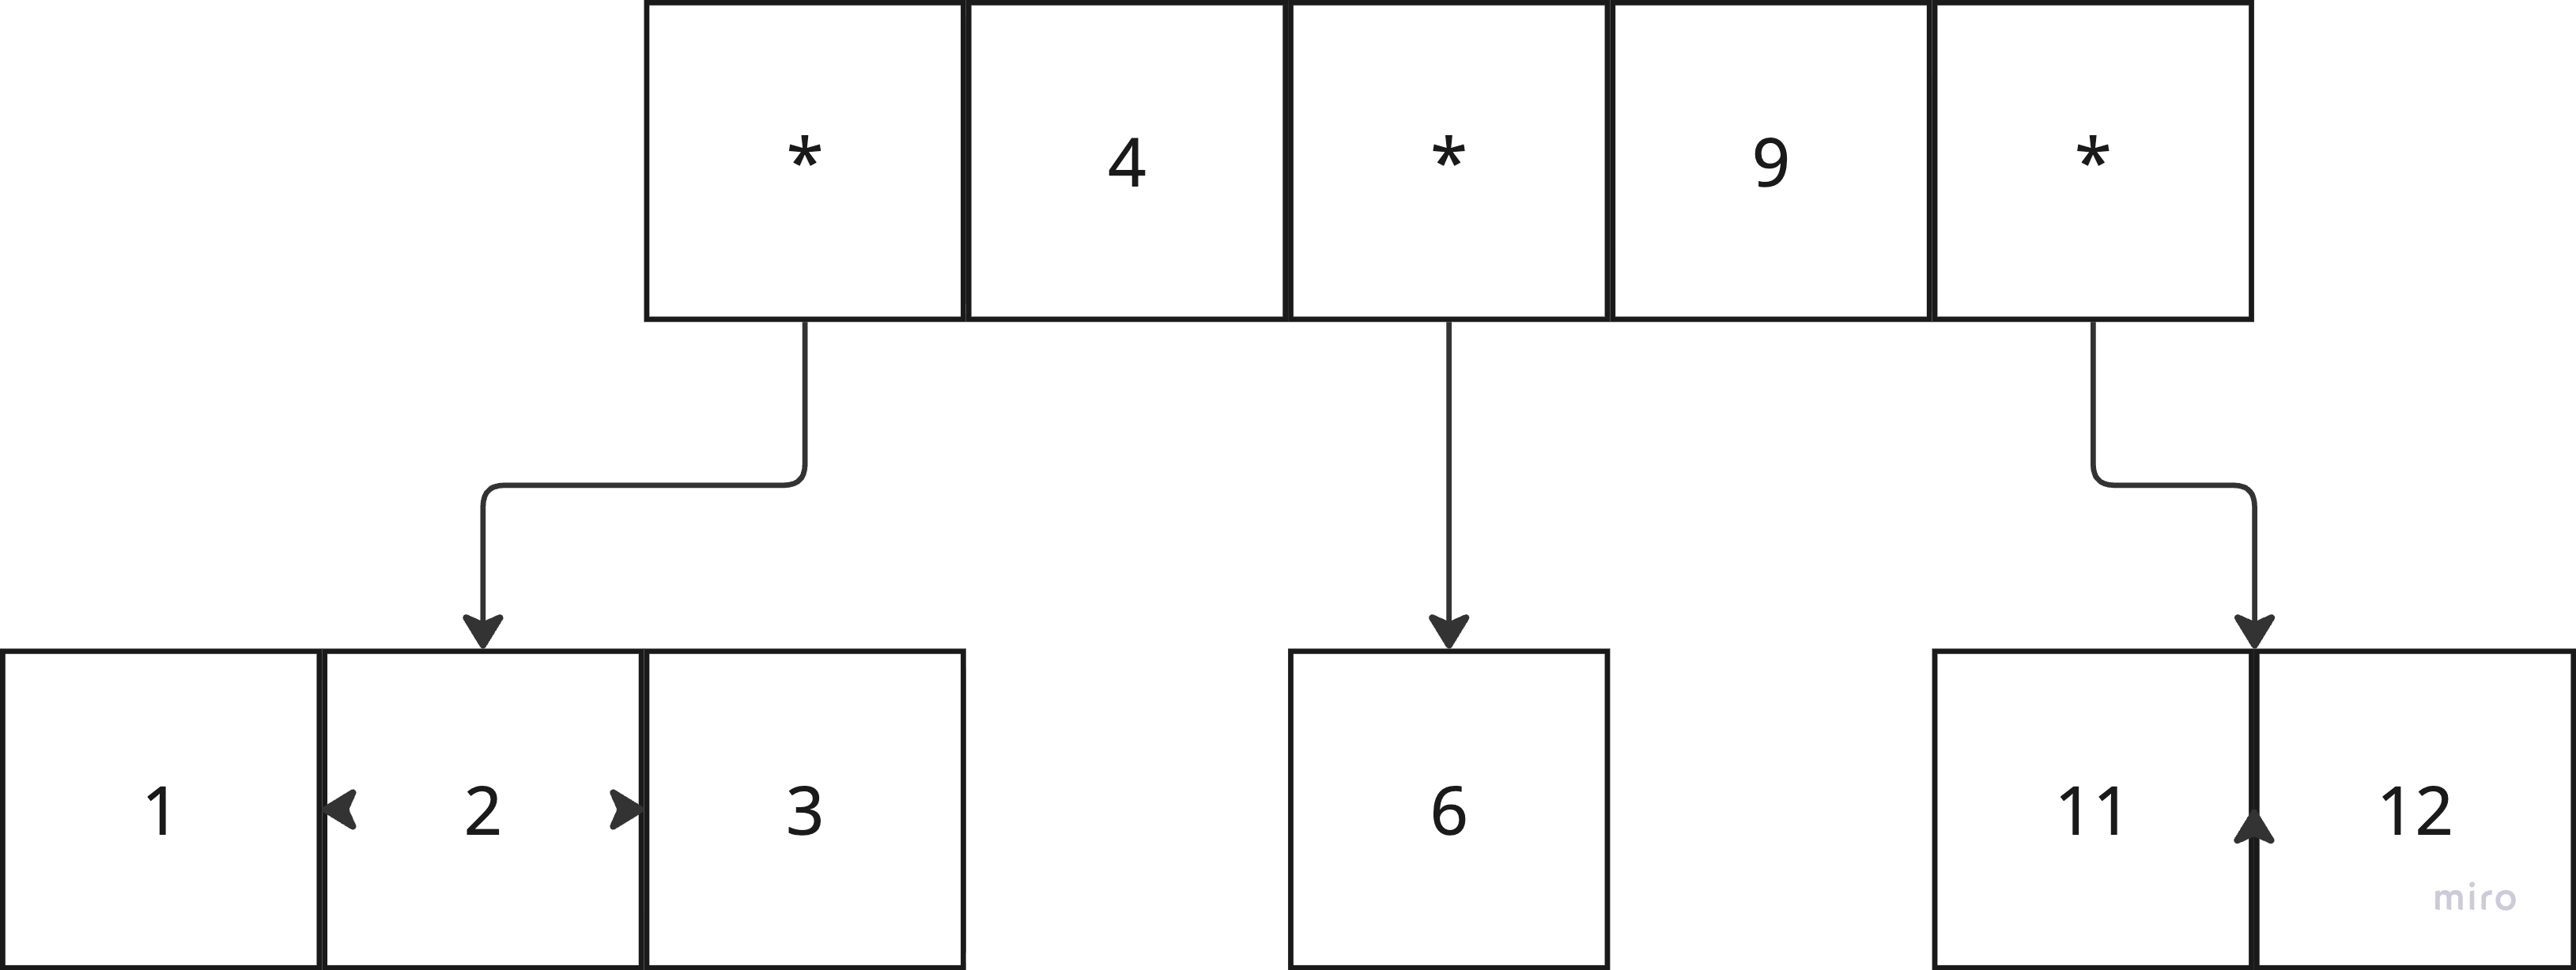
* がポインタで、それぞれのポインタはキーで区切られた範囲の子ノードを指します。例えば、ルートの一番左のポインタは「4 未満のキーを持つノード」を、真ん中のポインタは「4 以上 9 未満」を、一番右は「9 以上」を指します。
6 を探すときは、ルートで 4 <= 6 < 9 なので真ん中のポインタを辿り、真ん中のリーフノードに到達することで見つけられます。
特徴は以下のとおりです。
- 各ノードに複数のキーが入る(ノードのサイズはディスクのページサイズに合わせるのが一般的)
- 木の高さが低く、
O(log n)で探索できる - 内部ノードにも値(または値へのポインタ)を持つ
B+tree
B+tree は B-tree の派生で、現代のリレーショナルデータベースで広く使われている構造です。B-tree との違いは以下の2点です。
- 値はリーフノードにのみ格納される(内部ノードはキーだけ)
- リーフノード同士が連結リストでつながっている
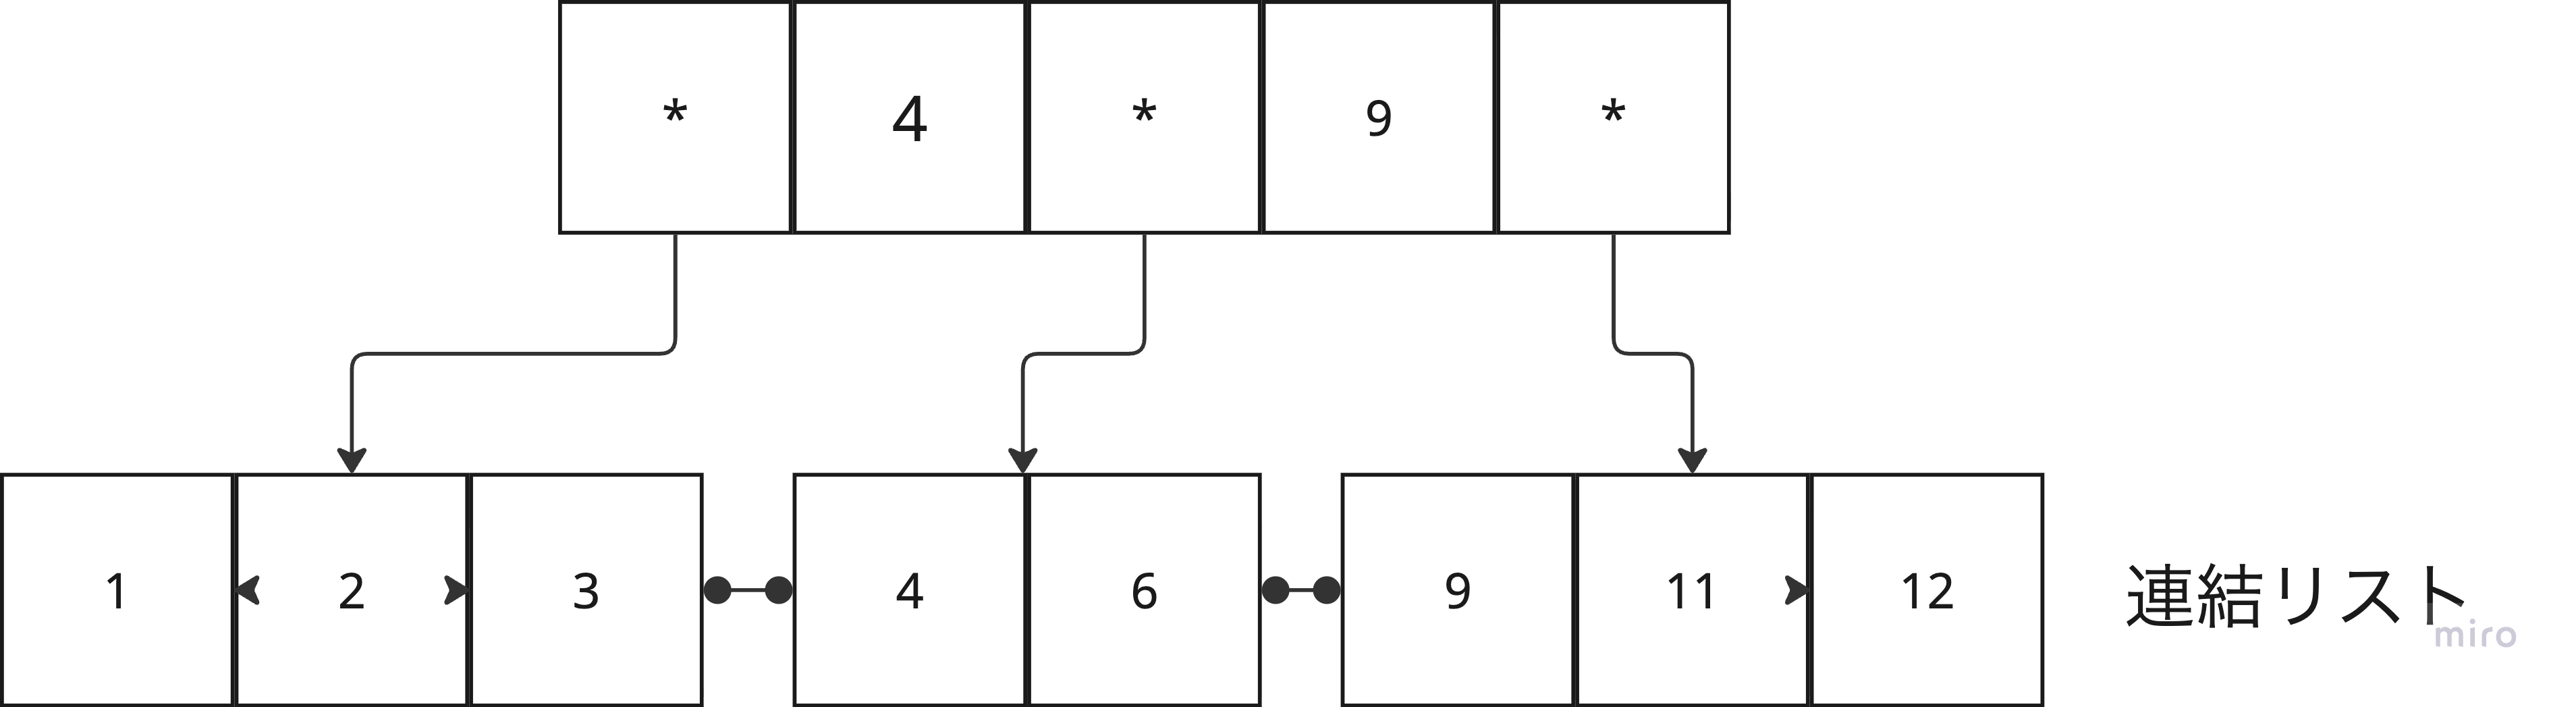
* は子ノードへのポインタ1ノードあ、・-・ はリーフ間の連結リストを表しています。
内部ノードに値を持たない分、たりに収まるキーが増え、結果として木の高さが下がりやすいのがメリットです。
また、リーフが連結リストでつながっているおかげで範囲スキャンが高速です。例えば「4 以上 9 未満」のようなクエリは、起点のリーフを見つけたあとは隣のリーフを順に辿るだけで済みます。
まとめ
B-tree / B+tree は読み込みや範囲スキャンに強く、PostgreSQL や MySQL など多くの RDBMS で採用されています。一方で、書き込みヘビーなワークロード向けには LSM-tree という別アプローチもあるので、こちらは別記事でまとめてみます。